Обложка — тематическая ИИ-иллюстрация BrookStone. Реальные материалы и схемы подписаны ниже.
Команда ggml-org объявила версии 1.0.0 библиотек llama.cpp и ggml. За новостью скрывается важная для локального ИИ вещь: более понятные правила совместимости библиотек, на которые опираются другие приложения. Это не выпуск новой языковой модели с названием «Llama 1.0».
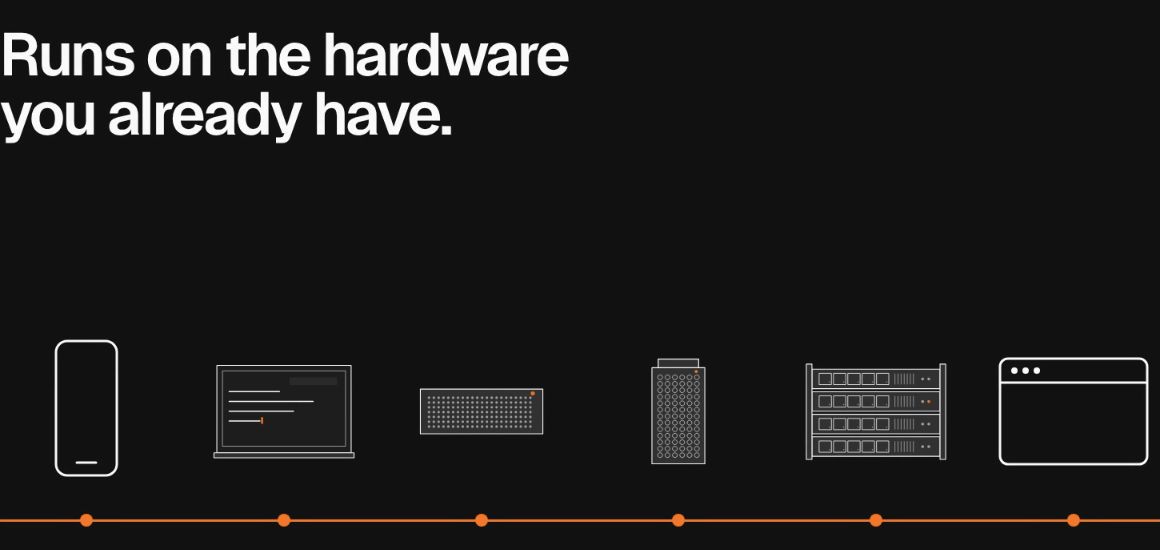 Кадр официальной анимации ggml-org о поддержке оборудования.
Зачем понадобилась единица в версии
Разработчики обещают обозначать несовместимые изменения публичного API и ABI увеличением основного номера. Совместимые функции, поддержка моделей и обновления вычислительных механизмов относятся к младшему номеру, исправления без изменения API — к номеру патча. Для авторов приложений такой договор облегчает планирование обновлений и проверку зависимостей.
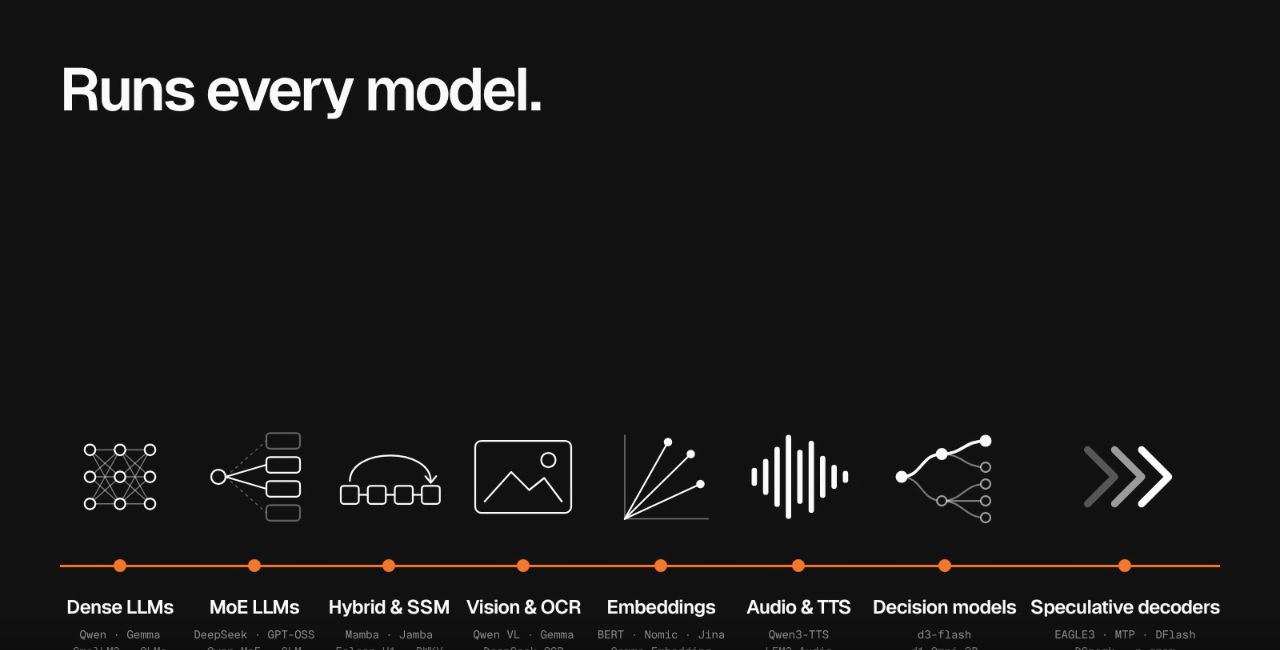 Кадр официальной анимации ggml-org о поддерживаемых моделях.
Где здесь локальный ИИ
llama.cpp выполняет модели на собственной машине — от потребительских компьютеров до серверов. Проект использует C/C++, оптимизированные вычислительные механизмы и квантование. Команда сообщает о поддержке более 150 вариантов архитектур. Однако число поддерживаемых архитектур ничего не говорит о скорости конкретной модели на конкретном ПК: значение имеют память, размер весов и выбранный способ вычислений.
С чего начинать пользователю
Сначала определите задачу: черновики текста, поиск по своим документам или обработка изображений требуют разных моделей и ресурсов. Затем проверьте лицензию весов и требования приложения, через которое планируется запуск. Локальное исполнение само по себе не гарантирует, что сторонняя оболочка ничего не отправляет в сеть: это отдельная настройка и свойство программы. Для рабочих внедрений полезно фиксировать версии и тестировать обновления на привычных примерах. Анонс опубликован Daniel Bevenius, Georgi Gerganov и Merve от имени ggml-org 13 ноября. Официальные анимации доступны в первоисточнике.


